Le réflexe VM, et pourquoi il ne marche plus#
Quand on vient de l’infra classique, la sauvegarde c’est un réflexe simple : tu as N machines virtuelles, tu colles un agent ou un proxy dessus, tu snapshottes les VMDK, et tu envoies tout ça sur un dépôt. Une VM = une sauvegarde. Tu perds un hyperviseur, tu restaures les VM une par une, et la vie continue.
Sur Kubernetes, la même recette coûte cher et ne protège pas grand-chose.
Sauvegarder mes nœuds Talos, par exemple, n’a strictement aucun intérêt. Ce sont des machines immuables, sans état, provisionnées depuis un machineconfig versionné. Si j’en perds une, je ne la restaure pas : je la recrée. C’est plus rapide, et le résultat est propre : pas de dérive, pas de résidu. La restauration d’un nœud Talos, chez moi, c’est un talosctl apply-config et cinq minutes d’attente.
Ce qui compte vraiment sur un cluster, il n’y en a que deux morceaux :
- etcd, qui contient l’état déclaré du cluster (tous les objets de l’API).
- les PVC, c’est-à-dire les seules données que Kubernetes ne sait pas recréer tout seul.
Le reste est du consommable.
Le cas GitOps : etcd devient presque un cache#
Et là, deuxième couche de simplification. Mon cluster est piloté à 100 % en GitOps avec ArgoCD. Chaque Deployment, chaque Ingress, chaque HelmRelease, chaque ConfigMap vit dans un dépôt Git. Rien n’est appliqué à la main. Si quelque chose existe dans le cluster sans exister dans Git, c’est une anomalie à corriger.
Conséquence directe : etcd n’est plus une source de vérité, c’est un cache.
Si je perds intégralement etcd, je ne perds pas de données : je reprovisionne un control plane, je réinstalle ArgoCD, je pointe l’App-of-Apps sur mon dépôt, et le cluster se réconcilie tout seul. Compter une heure.
Ce qui ne se reconstruit pas depuis Git, en revanche, c’est le contenu de mes volumes. La base PostgreSQL derrière Immich, les objets de Nextcloud, l’état de Authentik. Ça, si je le perds, Git ne me le rendra pas.
Donc mon périmètre de sauvegarde se réduit à une phrase : les PVC, plus le strict minimum de métadonnées nécessaires pour les rattacher aux bons workloads.
C’est une posture assumée. Elle n’est valable que parce que le GitOps est réellement à 100 %. Si tu as encore des kubectl apply manuels qui traînent en prod, ne la copie pas telle quelle — commence par nettoyer ça, sinon ta sauvegarde a des trous.
Petit rappel CSI (le strict nécessaire)#
J’ai déjà détaillé le fonctionnement de CSI dans un article précédent, donc je fais court.
CSI, c’est l’interface standard entre Kubernetes et le stockage. Elle définit notamment une API de snapshot avec trois objets :
VolumeSnapshotClass: le “comment” — quel driver, quelle politique de suppression.VolumeSnapshot: la demande, namespacée, à côté du PVC.VolumeSnapshotContent: l’objet cluster-scoped qui représente le snapshot réel côté stockage.
Chez moi, le driver c’est LINSTOR (Piraeus), en hyperconvergé sur DRBD avec du LVM thin. Et c’est ce qui rend tout le reste possible : LINSTOR expose le snapshot CSI nativement. Sans ça, on retombe sur du backup fichier via un sidecar — et sur une cohérence approximative dès qu’il y a une base de données derrière.
Un détail qui a son importance : le LVM doit être en thin, pas en thick. Un pool thick ne remonte pas CanSnapshots: True, et Velero ignore alors le volume sans rien signaler d’explicite.
Velero n’est pas un outil de sauvegarde#
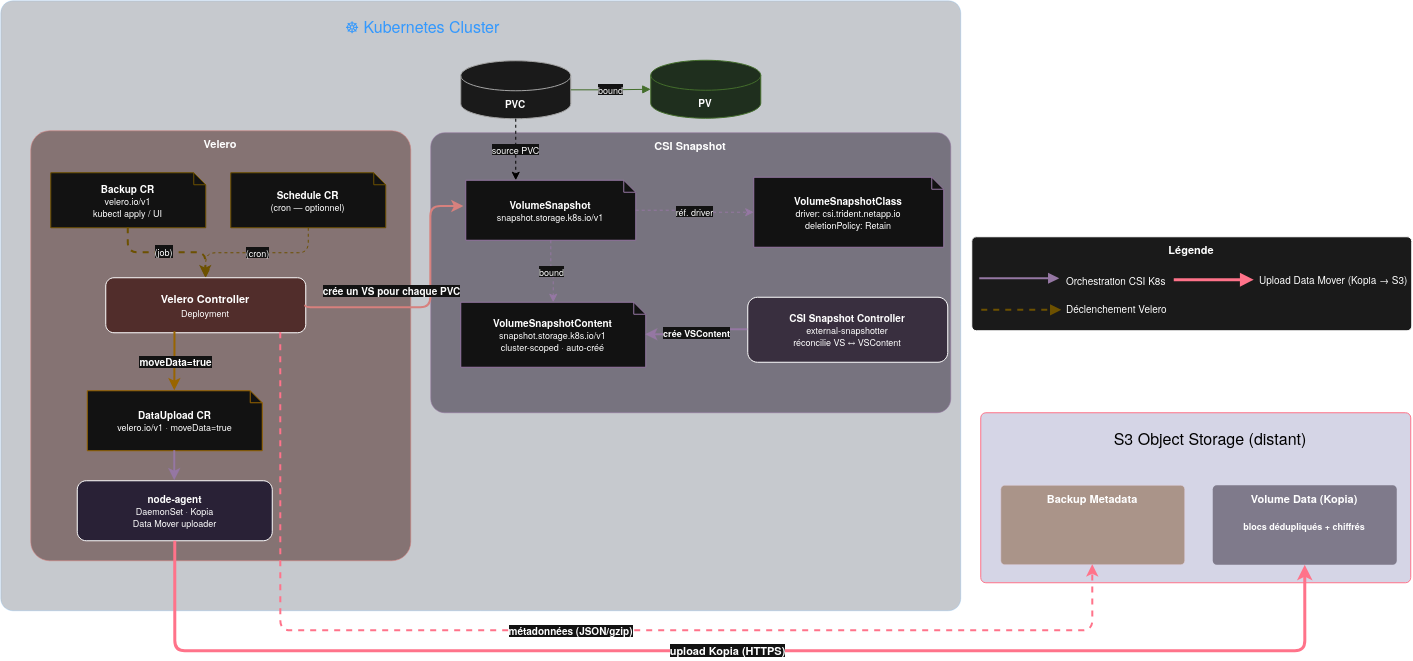
C’est la phrase que j’aurais aimé lire au début. Velero ne sauvegarde rien lui-même : il orchestre.
Son travail, c’est de :
- Sélectionner un périmètre (namespaces, labels, types de ressources).
- Sérialiser les objets Kubernetes correspondants et les pousser dans un bucket S3.
- Déclencher les snapshots de volumes en déléguant au CSI.
- Suivre l’état de tout ça via ses propres CRD, et savoir refaire le chemin à l’envers.
Toute l’intelligence “stockage” reste chez le driver CSI. Velero, lui, sait quoi demander, à qui, dans quel ordre, et où ranger le résultat — une couche d’orchestration portable, qui ne dépend pas de ma stack de stockage.
Le vrai sujet : sortir la donnée du cluster#
Un snapshot LINSTOR est local. Il vit dans le même pool LVM, sur les mêmes nœuds, répliqué par le même DRBD que le volume d’origine. Pratique pour revenir en arrière après un DROP TABLE malheureux : c’est immédiat et ça ne coûte presque rien.
Mais si je perds mes nœuds — incendie, erreur humaine, corruption du pool — je perds le volume et son snapshot en même temps. Un snapshot local est un point de restauration, pas une sauvegarde.
Il faut donc sortir la donnée du cluster. C’est le rôle du Data Mover.
Comment fonctionne le Data Mover, concrètement#
Quand un backup avec snapshotMoveData: true se déclenche, voilà ce qui se passe :
1. Velero sérialise les objets Kubernetes du périmètre vers le bucket S3. C’est la partie “métadonnées”, rapide et légère.
2. Pour chaque PVC éligible, le plugin CSI crée un VolumeSnapshot, et LINSTOR crée le snapshot correspondant dans le pool thin. L’application n’est bloquée que le temps du snapshot — quelques centaines de millisecondes.
3. Le plugin CSI émet ensuite une CR DataUpload par snapshot : le ticket de travail. Le node-agent, déployé en DaemonSet, le prend en charge, mais le transfert lui-même se fera dans un pod dédié, sur un seul nœud.
4. Le node-agent provisionne un PVC temporaire à partir du snapshot et le monte dans ce pod. Toute la lecture se fait sur cette copie figée : la production n’est jamais touchée.
5. Kopia pousse les blocs vers S3, dédupliqués et incrémentaux — seuls les blocs modifiés depuis la sauvegarde précédente transitent sur le réseau. La DataUpload passe en Completed, puis le pod, le PVC temporaire et le snapshot local sont nettoyés.
À la restauration, c’est le miroir exact : une CR DataDownload par volume, un PVC vierge provisionné, Kopia qui réhydrate les blocs depuis S3, et Velero qui recrée les objets Kubernetes autour.
Ce qui est bien pensé, c’est le découplage. Le snapshot CSI garantit la cohérence (image figée à un instant T), et Kopia garantit la durabilité (donnée sortie du cluster, dédupliquée, chiffrée). Chaque brique fait une seule chose.
Ce que ça donne en pratique#
Le Schedule type, chez moi :
apiVersion: velero.io/v1
kind: Schedule
metadata:
  name: daily-critical
  namespace: velero
spec:
  schedule: "0 2 * * *"
  template:
    ttl: 720h                      # 30 jours de rétention
    snapshotMoveData: true         # <- bascule du snapshot local vers le Data Mover
    defaultVolumesToFsBackup: false
    storageLocation: s3-external
    includedNamespaces:
      - immich
      - nextcloud
      - authentik
snapshotMoveData: true est la ligne qui bascule du snapshot local vers le Data Mover. Sans elle, Velero se contente de créer un VolumeSnapshotContent et de noter sa référence dans le backup — ce qui ne te sert plus à rien le jour où le cluster n’existe plus.
Côté destination, le bucket S3 est en dehors du cluster. Ça paraît évident écrit comme ça, mais c’est la première erreur que j’ai faite : pointer Velero vers un S3 hébergé sur le cluster qu’il est censé sauvegarder. Le jour où tu en as besoin, les deux sont indisponibles en même temps.
Deux ou trois pièges qui m’ont coûté du temps#
La deletionPolicy de la VolumeSnapshotClass. Par défaut elle est en Delete. Sur le papier c’est propre — le snapshot local disparaît quand la sauvegarde est terminée. En pratique, avec LINSTOR, j’ai préféré passer piraeus-snapclass en Retain pour garder la main sur le cycle de vie et éviter que le contrôleur ne me supprime des contents encore référencés pendant une opération en cours.
Le revers : ça génère des VolumeSnapshotContent orphelins qu’il faut nettoyer périodiquement. Un CronJob qui liste les VSC sans VolumeSnapshot associé et les supprime fait très bien le travail.
Le temps de provisioning du PVC temporaire. Sur des volumes de plusieurs centaines de gigas, LINSTOR met du temps à provisionner la copie depuis le snapshot. Si tu dépasses le data-mover-prepare-timeout du node-agent — 30 minutes par défaut — la DataUpload est annulée. Surveille cette durée avant d’en arriver là.
Le premier backup est long. Kopia n’a rien en cache, il pousse tout. C’est normal. Les suivants sont incrémentaux et durent une fraction du temps. Ne juge pas ta fenêtre de sauvegarde sur le premier run.
Tester la restauration, sinon rien#
Une sauvegarde jamais restaurée n’a jamais été vérifiée. Tant que tu n’as pas fait l’exercice au moins une fois, tu ne sais pas si elle fonctionne.
Mon rituel, c’est une restauration dans un namespace bac à sable :
velero restore create test-immich \
  --from-backup daily-critical-20260809020000 \
  --include-namespaces immich \
  --namespace-mappings immich:immich-restore-test
Puis je vérifie les DataDownload en cours :
kubectl -n velero get datadownloads -l velero.io/restore-name=test-immich
Et surtout, je vérifie que l’application démarre et que la donnée est cohérente, pas juste que le PVC est monté. Un volume qui se monte avec une base corrompue dedans, ça ne sert à rien.
Bonus : il existe une UI#
Découvert bien trop tard : tout ce que je décris ici en YAML et en velero backup describe existe aussi dans une interface web, Velero UI. Elle donne :
- la vue d’ensemble des backups, schedules et restores ;
- l’état des
DataUploadetDataDownloaden temps réel ; - les logs du serveur et des node-agents, sans passer par
kubectl logs; - le déclenchement d’une restauration en quelques clics.
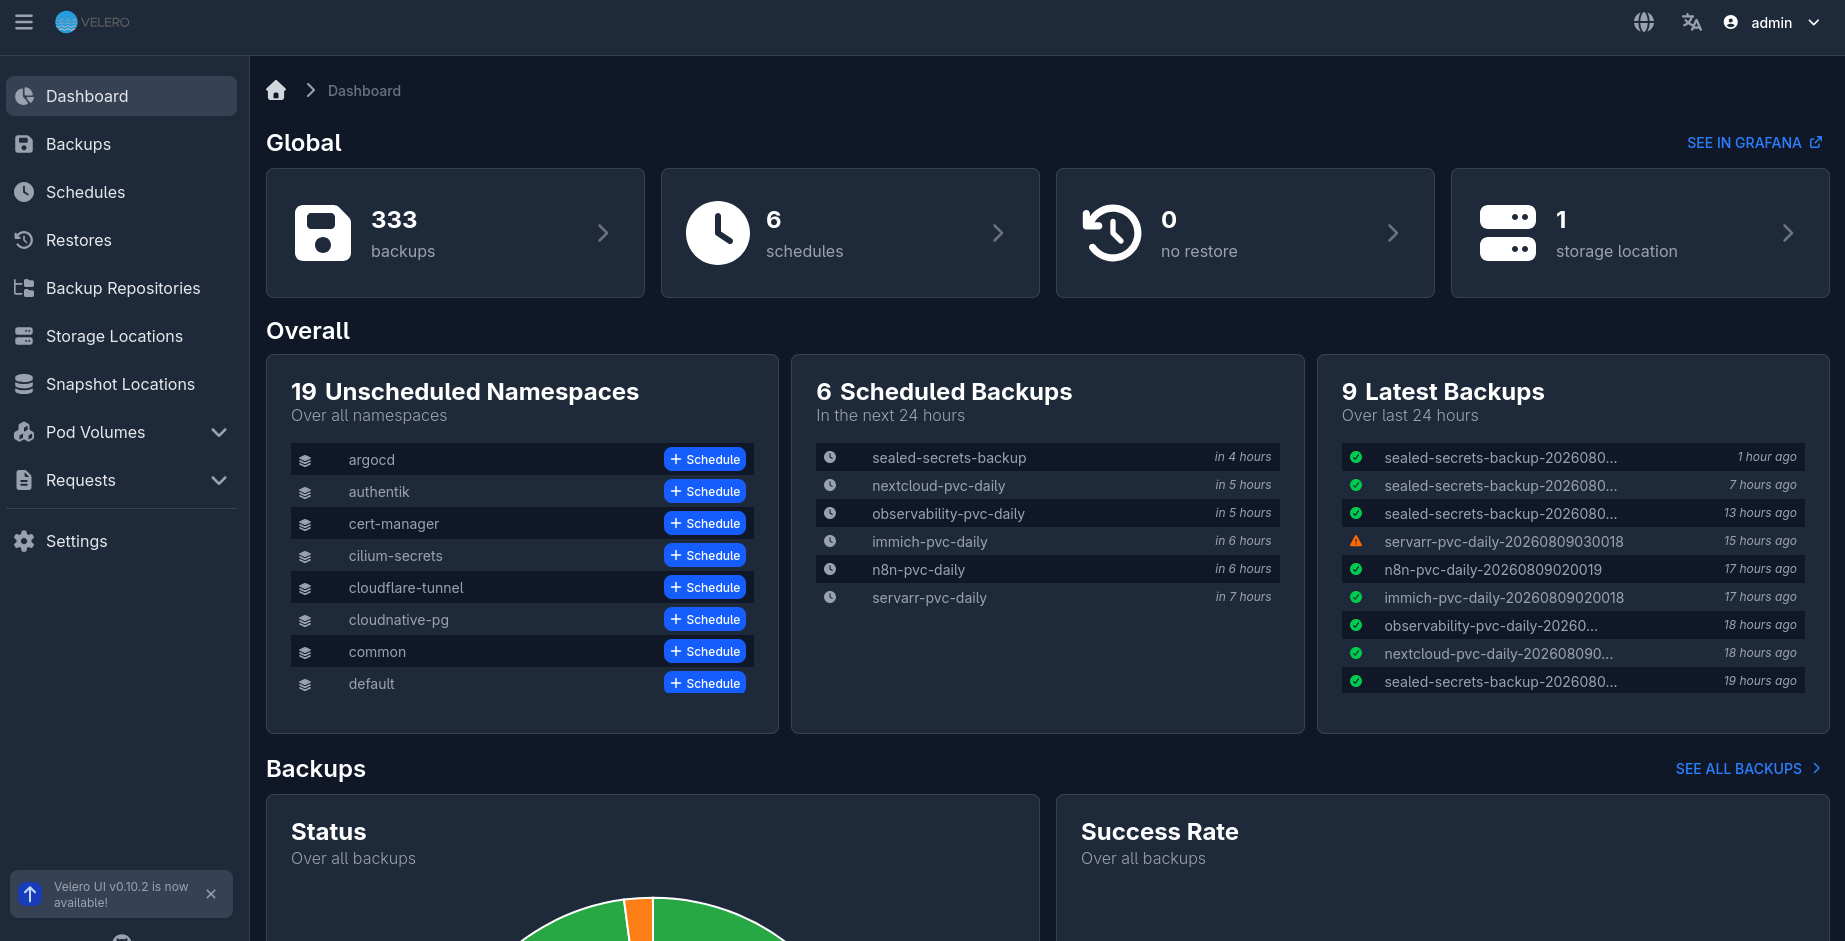
Je continue à déclarer mes Schedule dans Git — GitOps oblige, pas question de créer des objets à la main depuis une interface. Mais pour le run quotidien, c’est un confort réel : un coup d’œil au dashboard le matin me dit si la fenêtre de nuit s’est bien passée. Et en restauration d’urgence, avoir les points de restauration sous les yeux plutôt que dans un terminal évite les fautes de frappe sur un nom de backup.
Pour résumer#
Sauvegarder Kubernetes, ce n’est pas dupliquer des machines. C’est identifier le petit sous-ensemble d’état qui n’est reconstructible depuis nulle part ailleurs, et le protéger correctement. Dans une infra GitOps, ce sous-ensemble se réduit aux volumes persistants — le reste est dans Git, en supposant que ton dépôt Git soit lui-même sauvegardé.
L’architecture qui en découle tient en trois briques : le CSI fournit la cohérence, Velero l’orchestration et la portabilité, le Data Mover la durabilité hors cluster. Le tout piloté par un Schedule de quinze lignes.
Le plus dur, au fond, c’est de répondre honnêtement à une question : qu’est-ce que je ne peux pas reconstruire ?